这两天,我的LibTV账户里还剩四万五千多积分,几个模型的限时权益只剩两天。
想把积分花完很容易。复制一条提示词,换几个模型点一遍,等视频出来就行。可我更想用这些积分换回一点以后还能用的东西。几条作品,一次真实比较,以及一份可以拿去分享的经验。
于是我用六个视频模型做了两轮广告实验。
我先把话说在前面。我对这六个模型都谈不上熟练,每个模型也只生成了一次。下面这些感受,只对应这次提示词、这次平台入口和这一次抽卡。换一个场景,结果很可能重新洗牌。
这大概也正是我想记录它的原因。
同一条提示词跑六遍
第一轮,我给六个模型用了完全相同的提示词。
任务是一条十五秒的虚构高端香水广告。产品叫LUMINA,场景在雨夜酒店。女主穿黑色礼服,从窗边走向石台,拿起透明香水瓶,最后落到产品定格。
六个模型都采用16:9横版、十五秒、纯文字生成,不放人物参考图,也不放产品图。提示词优化关闭,每个模型只跑一遍。
参与的模型有Seedance 2.5、Seedance 2.0 Fast VIP、Seedance 2.0 Mini、Wan 3.0、HappyHorse 1.1和MiniMax H3 Max。
第一轮六条实测视频可在公众号原文中观看。
成片摆在一起,差别很直观。
有的模型很会做香水广告的气氛。雨夜、玻璃、高光、黑裙和慢镜头都齐了,一眼看上去确实像那么回事。有的模型对瓶身文字更稳定,LUMINA居然能完整保留下来。有的产品镜头很好看,人物一拿起瓶子,比例和瓶盖却开始悄悄变化。
人物的差异更明显。
我在提示词里写的是二十八岁东亚女性,Seedance 2.5生成的人物却显得成熟许多。我个人看着还有点像某位好莱坞华裔演员。这个判断很主观,但它会直接影响我是否愿意把画面交给客户。
另外两条片子里,人物站在窗前呼出一团明显白气。雨夜酒店的氛围有了,室内为什么冷到能哈出白气,片子没有交代。模型可能在努力理解“呼吸轻微可见”,结果执行得过于认真。
还有模型把克制的情绪做成了广告式微笑。你很难说画面难看,只是人物没有照着提示词里的状态走。
如果只截最后一帧来比,很多模型都不错。真正播放起来,人物年龄、手部动作、瓶子形状、液面和情绪变化才会逐渐露出差异。
第一轮让我确认了一件事。同一条提示词可以看出基础差异,却很难决定一个模型到底适合做什么。让所有人参加同一场考试,公平是公平了,考试科目未必是每个人最擅长的那一门。
我又给它们各换了一道题
第二轮,我根据公开资料和创作者案例,给六个模型各挑了一个更可能发挥的场景。
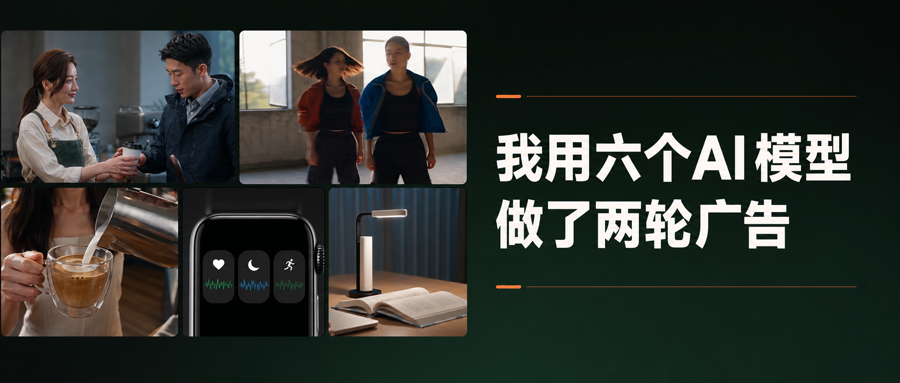
Seedance 2.5做三十秒都市女性时装片,并且垫了一张人物参考图。Wan 3.0做双人咖啡馆短剧。MiniMax H3 Max做智能手表动态图形广告。HappyHorse 1.1做双人街舞。Seedance 2.0 Fast VIP做咖啡一镜到底。Seedance 2.0 Mini做磁吸桌面灯信息流广告。
这轮已经不追求公平。我要看的,是模型放到合适的位置以后,能不能更接近可用。
第二轮有四条视频收录在公众号原文中,另外两条受公众号单篇视频数量限制未能放入。
Seedance 2.5加入人物参考图以后,上一轮的年龄感问题明显改善。三十秒里,人物身份和整体气质保持得比较稳,酒店房间、走廊和外部空间也有连续变化。参考图对真人广告的帮助,比我继续往提示词里堆外貌形容词更直接。
Wan 3.0的双人咖啡馆完成度很高。咖啡师和顾客的关系清楚,人物站位、杯子和对白都能接起来。这条片已经具备短剧式广告的基本样子。它仍然只是一次结果,我暂时愿意在双人互动和原生对白场景里优先试它。
HappyHorse 1.1的两位舞者也给了我惊喜。蓝色和橙色服装区分清楚,双人动作有力量,镜头里的空间关系大致成立。复杂的肢体接触还需要逐帧检查,但它至少让人愿意继续测试运动和舞蹈。
MiniMax H3 Max的手表广告很像一条完整的动态图形短片。PULSE ONE、HEART 72、SLEEP 86和RUN 5.2 KM基本可读,黑色与电光蓝的视觉也比较统一。
单次价格只是账单的一小部分
做完两轮以后,我越来越在意“一次生成可用率”。
模型页面上的积分价格很容易比较。真正交付一条广告,还要算人物参考图、产品图、提示词修改、重抽次数、后期修正和人工检查。
H3第一次画幅错误,需要再跑一次。Mini的台灯若想拿去交付,也得重写任务或重新生成。Seedance 2.5成本高一些,人物参考图却减少了年龄漂移。这里没有一个简单的答案。
便宜模型一次做到需求,当然划算。贵模型如果能少抽几遍,最后也可能更省。价格要和任务放在一起看。
商业里还有一个很朴素的问题。视频做得更贵,产品不会自动卖得更好。
很多信息流视频只需要把一个利益点讲明白。用户看懂了,画面没有明显错误,成本又低,它就可能够用。高端品牌片需要人物、材质、灯光和节奏都更讲究,预算自然会往上走。
客户购买的是传播效果和具体用途,很少有人专门为“用了更贵的模型”付钱。
观众能不能看懂它在说什么,画面里的错误会不会伤害产品和品牌,达到需求以后,积分、重抽和后期成本是否合适。
这三个问题答完,再讨论哪一个模型更强,心里会稳很多。
这算不上模型排行榜
我也还在学习怎么用这些模型。提示词的写法、参考素材、平台入口和随机性,都会改变结果。网上那些长期研究视频模型的创作者,肯定能把每一个模型用得比我更深。
我更愿意把这两轮看成一次小白的现场记录。
第一轮让我看见,同一条提示词交给不同模型,会长成六种理解。第二轮让我看见,模型进入不同场景以后,亮点和短板会一起出来。
我没有找到一个可以包办所有广告的冠军。
倒是留下了一个以后还能继续用的方法。先用统一任务看基础能力,再用专长任务看实际可用率。每次只生成一遍,保留失败,不急着用重抽把问题藏起来。等样本多一点,再调整自己的判断。
对刚开始做AI视频的人来说,这也许比背一张模型排名表更有用。
下一次接到真实需求时,你不必先问哪个模型最厉害。先看客户要表达什么,哪些地方绝对不能错,最后才决定把积分花在哪里。
我手里还有不少积分。
这次,我大概知道该怎么花了。
本文观点、经历及最终判断来自作者,AI参与文字整理与配图生成。